 WZE测评
2026-10-20 下午,DMIT 公告 LAX 区域 AS9929 骨干丢包升高。我们这边 15 台机器同时看到了这次故障,也看到了同一时间、同一机房、走另一条线路的对照组完全没事。
这篇不转述公告,用当天的实测数据讲清楚三件事:怎么判断故障在谁身上、为什么「都叫 9929」表现能差这么多、选机时该看什么。
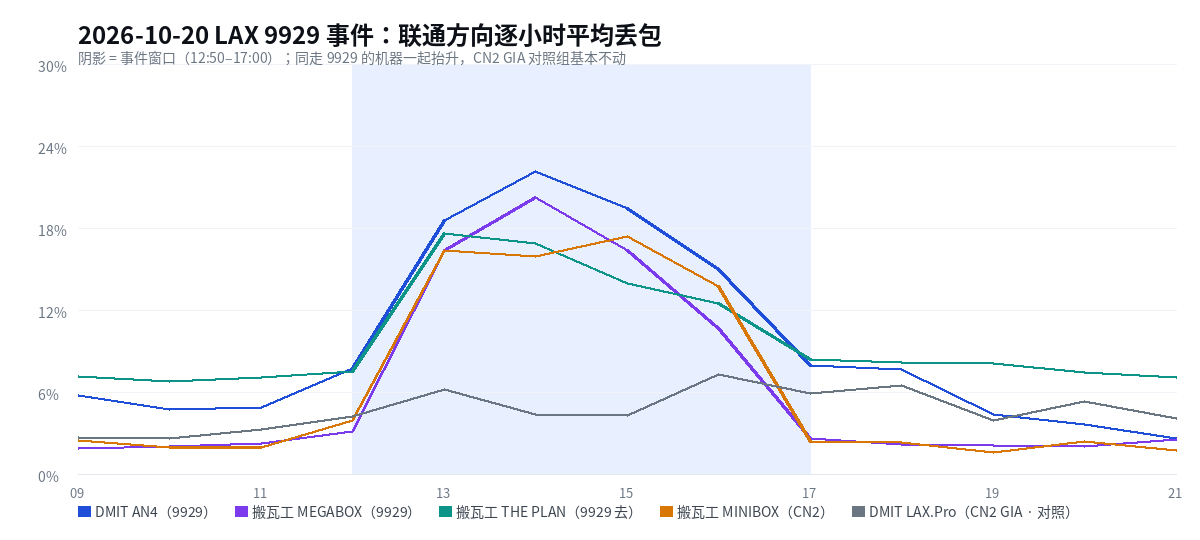
一、先把时间线钉死
看的是我们自己监控的 5 分钟粒度数据(每轮 20 个 ICMP 包,取北京/上海/广州/南京四城平均):
| 时间 | DMIT AN4 联通方向 | 说明 |
|---|---|---|
| 12:00–12:40 | 5–7% / 155 ms | 正常水平(含对端限速基线) |
| 12:50 | 12.6% / 182 ms | 丢包开始抬头 |
| 13:00–16:40 | 15–26% / 192–204 ms | 持续高位,14:10 峰值 26.0% |
| 16:50 | 9.3% / 175 ms | 开始回落 |
| 17:00 | 6.2% / 149 ms | 延迟先恢复 |
| 19:00 之后 | 2–5% / 153 ms | 回落到基线以下 |
结论:12:50 开始、17:00 延迟恢复,影响约 4 小时。
二、不是一台机器的事:同走 9929 的一起劣化
| 机器 | 联通 · 基线 | 联通 · 事件窗口 | 联通 · 恢复后 | 延迟变化 |
|---|---|---|---|---|
| DMIT LAX.AN4 | 5.43% | 18.53% | 3.70% | 155 → 194 → 153 ms |
| 搬瓦工 MEGABOX | 2.22% | 15.54% | 2.16% | 159 → 197 → 158 ms |
| 搬瓦工 THE PLAN | 7.22% | 14.90% | 7.64% | 157 → 182 → 160 ms |
| 搬瓦工 MINIBOX | 2.22% | 15.60% | 1.94% | 155 → 197 → 157 ms |
| DMIT LAX.Pro(CN2 GIA) | 3.60% | 5.46% | 4.52% | 159 → 159 → 161 ms |
基线 = 事件前 2 小时(10:50–12:50);事件窗口 = 12:50–17:00;恢复后 = 19:00–22:00。
四个走 9929 的机房,联通方向在同一个 10 分钟里一起跳上去、又在同一时间回落——这种同步性基本排除了「单台机器被攻击」「单台机器超售」这类解释,指向共同经过的那段骨干。
三、对照组为什么重要
DMIT LAX.Pro 和 DMIT AN4 在同一个机房、同一家上游、同样对国内联通:
- AN4 联通 5.43% → 18.53%
- LAX.Pro 联通 3.60% → 5.46%(几乎没动)
两台唯一的区别是走的线路不同(LAX.Pro 是 CN2 GIA)。同一时间、同一地点,一条线路炸了、另一条没事,这就把「LAX 机房整体故障」也排除掉了——问题在 9929 这一段,不在机房。
四、一个公告没提的细节
DMIT AN4 这台机器,电信方向也在同一时间劣化了:
| 机器 | 电信 · 基线 | 电信 · 事件窗口 | 电信 · 恢复后 |
|---|---|---|---|
| DMIT AN4 | 4.39% / 161 ms | 16.12% / 201 ms | 4.29% / 167 ms |
| 搬瓦工 MEGABOX | 4.30% / 150 ms | 4.39% / 152 ms | 3.98% / 152 ms |
| 搬瓦工 THE PLAN | 4.27% / 151 ms | 3.96% / 154 ms | 4.65% / 153 ms |
| DMIT LAX.Pro | 4.33% / 153 ms | 4.49% / 155 ms | 3.84% / 151 ms |
别的机器电信方向都没动,只有 AN4 动了。所以这次故障对 AN4 来说,不只是 9929 骨干——它自己的上游/接入段也同时出现了问题(它的电信走的是 CTG GIA 那条)。
这也是为什么「一个公告只能解释一部分现象」:厂商公告说的是自己检测到的范围,实际影响要靠自己的监控去测量。
五、一套判断框架:故障到底在谁身上
下次再遇到「某台机器突然变差」,按这个顺序看数据,基本能定位:
-
是不是单台?
- 只有一台劣化 → 商家侧(超售、被攻击、机器故障)
- 多台同向劣化 → 继续看第 2 步 -
是不是同一条线路?
- 走同一线路(9929/CN2 GIA/CMIN2)的机器一起动 → 骨干/上游问题
- 不同线路一起动 → 可能是机房整体或共同上游 -
是不是同一家运营商?
- 只有联通动 → 联通段
- 电信也动 → 更上游,或机器接入段 -
有没有对照组?
- 同机房、不同线路的机器不动 → 排除机房整体
- 全都动 → 机房/上游整体 -
恢复曲线长什么样?
- 阶梯式恢复(延迟先回、丢包后回)→ 通常是上游调度/拥塞
- 突然恢复 → 更像设备/链路切换
这次 9929 事件,用第 1、2、4 条就能定性:多台、同线路、对照组没事 → 骨干段。
六、为什么「都叫 9929」表现能差这么多
同样是 9929(AS9929),并不等于同样的质量:
| 变量 | 影响 |
|---|---|
| 骨干段与接入点 | 从哪个城市上 9929、走哪条国际段,延迟与拥塞点完全不同 |
| 接入带宽 | 商家买的是 100M 还是 10G 端口,决定了高峰能分到多少 |
| 上游 transit | 9929 之外还要看海外段接的是谁(CUG/CTG/NTT…),这一段也可能出问题 |
| QoS 与调度策略 | 同样标 9929,有的商家买的是高优先级队列,有的只是「能走」 |
| 超售比例 | 端口再大,分给几十台机器的带宽也会在高峰被吃满 |
所以我们从不把「宣传线路名」当成结论——线路名只是可能走哪条路,实际质量要看实测。
七、选机时该看什么
- 看你自己的方向:你主要用电信,就看电信实测;别看「三网优化」这种宣传词
- 看同一线路的对照:同线路不同商家一起比,才能看出是链路问题还是商家问题
- 看晚高峰和长窗口:单次测速没有意义,30 小时/7 天的曲线才说明稳定性
- 看故障复盘:能把自己遇到的故障讲清楚(时间、范围、恢复)的站点,数据通常更可信
这次事件的完整数据(含逐小时曲线、每台机器的基线/事件/恢复对比)我们放在事件页,可随时回查:
- 事件页:https://wze.me/incidents/2026-10-20-lax-9929-loss
- DMIT AN4 实时曲线:https://ping.wze.me/dmit/smokeping/
- LAX.Pro 对照曲线:https://ping.wze.me/laxpro/smokeping/
八、边界与口径
- 丢包 = 每轮丢包个数 ÷ 20 × 100,四城平均;每 5 分钟一轮
- 电信目标存在对端 ICMP 限速,基线就有 3–5% 丢包,所以看变化量而不是绝对值
- 事件窗口 12:50–17:00 是按延迟与丢包的拐点人工划定的,不是厂商公告时间
- 四城平均会平滑掉单城市细节;要看单城市请看各机房报告页
- 本文数字来自本站监控,原始数据可在
facts/与data/wze.db回查